Als wir 1999 unsere ersten Websites bauten, bestand die ganze Arbeit aus HTML. Was wir schrieben, war das, was erschien. Der Browser mischte sich nicht ein und legte nichts eigenmächtig aus; die Seite war einfach die Seite.
Damals hatte Onpage-SEO die technische SEO noch nicht hervorgebracht, beides war eine einzige Sache. Wir sahen an drei Stellen nach: Title, Meta-Description und Meta-Keywords. Stimmten diese drei, war Onpage-SEO so gut wie erledigt.
AltaVista war in jenen Jahren eine Macht. Die Wörter, die wir ins Keywords-Feld tippten, bewegten dort tatsächlich etwas. Jenes Tag, das heute niemand mehr eines Blickes würdigt, stand damals mitten im Zentrum der Arbeit.
Seit 1999 hat sich vieles geändert. GEO kam hinzu, Next.js kam hinzu, Chrome hat den Browsermarkt übernommen. Auch die Onpage-SEO ist aus jenen drei Tags zu dem geworden, was sie heute ist.
Eines hat sich aber nie geändert. Code zählt in der SEO, Technik zählt, dagegen sage ich nichts. Den Ausschlag gibt jedoch, welches Produkt Sie vor die Menschen stellen.
Denken Sie es sich so. Auf YouTube wirkt Ihr Titel, wirkt Ihre Beschreibung. Warum sieht sich jemand ein Video aber wirklich an? Nicht wegen des Titels. Wegen des Videos. In der SEO ist es genauso. Technische Parameter zählen, entscheidend ist, was Ihre Website tatsächlich löst.
Warum Onpage-SEO immer zu spät kommt
Bisher war Onpage-SEO eine Arbeit dieser Art. Sie stellen die Website online. Danach sehen Sie sie mit ein paar Werkzeugen durch. Später, wenn in der Search Console Daten aufgelaufen sind, werten Sie diese aus.
Das heißt, wir bemerken das Übersehene erst, nachdem wir es übersehen haben.
Mir kam das immer verkehrt herum vor. Der günstigste Moment, einen Fehler zu beheben, ist der, in dem ihn noch niemand gesehen hat. Ihn eine Woche nach dem Start in der Search Console zu entdecken, zu beheben und dann auf den nächsten Crawl zu warten; das ist der teuerste Weg.
Der Grund ist einfach. Nahezu jedes Audit-Werkzeug arbeitet gleich: Sie geben eine Adresse an, deren Server ruft sie auf, lädt die Seite herunter, prüft sie. Was die Kette trägt, bricht sie zugleich. Die Seite muss von außen erreichbar sein.
Und wie viele nicht erreichbare Seiten gibt es? Mehr, als man denkt. Der localhost auf dem eigenen Rechner, der Staging-Server vor der Abnahme durch den Kunden, ein Intranet im Firmennetz, Mitgliederseiten hinter dem Login, der Warenkorb, die Kasse, der noch unveröffentlichte Entwurf. Alle sind echt. Alle treten eines Tages vor Google. Und keine davon lässt sich heute ansehen.
Die Engine hatten wir bereits
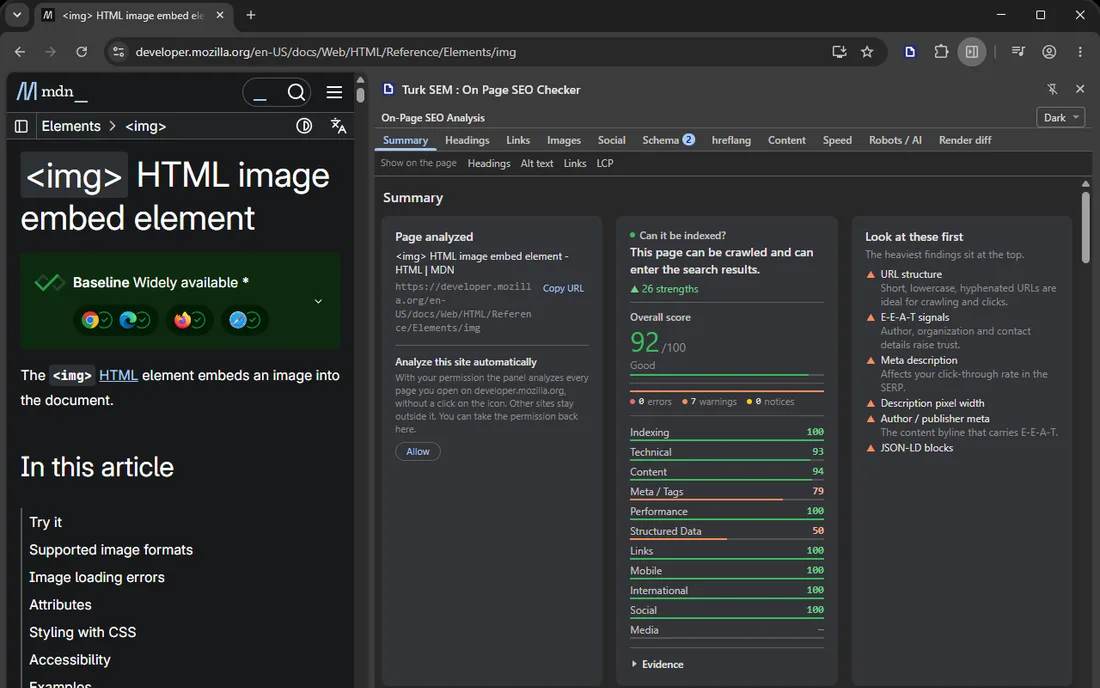
Eines Tages fiel es uns auf: Türk SEM betreibt längst eine gründliche SEO-Analyse-Engine, und wir richteten sie ausschließlich auf unser eigenes Dashboard.
Also sagten wir, nehmen wir diesen Onpage-Analysekern und verlegen ihn in eine Chrome-Erweiterung. Wo auch immer sie sitzen, Webentwickler sollen diese Probleme vor dem Start sehen, auf ihrem eigenen localhost, in ihrem eigenen Browser.
Unser Entwicklungsteam krempelte die Ärmel hoch. Nach Monaten Arbeit lebt die Engine nun in der Erweiterung. Die Analyse läuft vollständig im Browser. Ihre Seite wird nirgendwohin hochgeladen, und keine einzige Anfrage erreicht unsere Server. Sie könnte sie ohnehin nicht erreichen, denn das Einzige, was diese Seite sieht, ist Ihr eigener Browser.
Die praktische Seite gefällt mir auch. Kein Seitenlimit, kein Tageskontingent, keine Warteschlange. Analysieren Sie eine Seite fünfzigmal, es kostet niemanden etwas.
Worauf sie schaut
An diesem Teil haben wir am längsten gearbeitet. Werkzeuge, die eine Checkliste ausgeben, gibt es genug; wir wollten eines, das zu einem Urteil kommt.
Ein Urteil zur Indexierbarkeit
Ein Satz dazu, ob Google diese Seite in den Index aufnehmen kann. Fünf Signale stehen dahinter: Meta-Robots, X-Robots-Tag, robots.txt, Canonical und hreflang. Sie werden in der Reihenfolge gewichtet, die Google tatsächlich anwendet, und wenn sie einander widersprechen, wird der Widerspruch beim Namen genannt.
Ich gebe Ihnen ein Beispiel, das ich mag. Auf einem Pfad, den Sie in der robots.txt gesperrt haben, steht ein noindex. Wirkt vernünftig, nicht wahr, Sie haben die Tür zweimal geschlossen. Nur: Google lädt diese Seite nie herunter, liest das noindex also nie, und die Seite bleibt im Index. Zwei richtige Dinge ergeben nebeneinander ein falsches Ergebnis. Mit bloßem Auge ist das schwer zu bemerken.
Der Unterschied zwischen Quelltext und gerenderter Seite
Die Erweiterung stellt die erste Antwort des Servers neben die Seite, wie sie nach dem Ausführen von JavaScript aussieht. Title, Canonical, Meta-Robots, die H1-Folge und der hreflang-Satz stehen in zwei Spalten. Was JavaScript ergänzt hat, was es verändert hat; Sie sehen es.
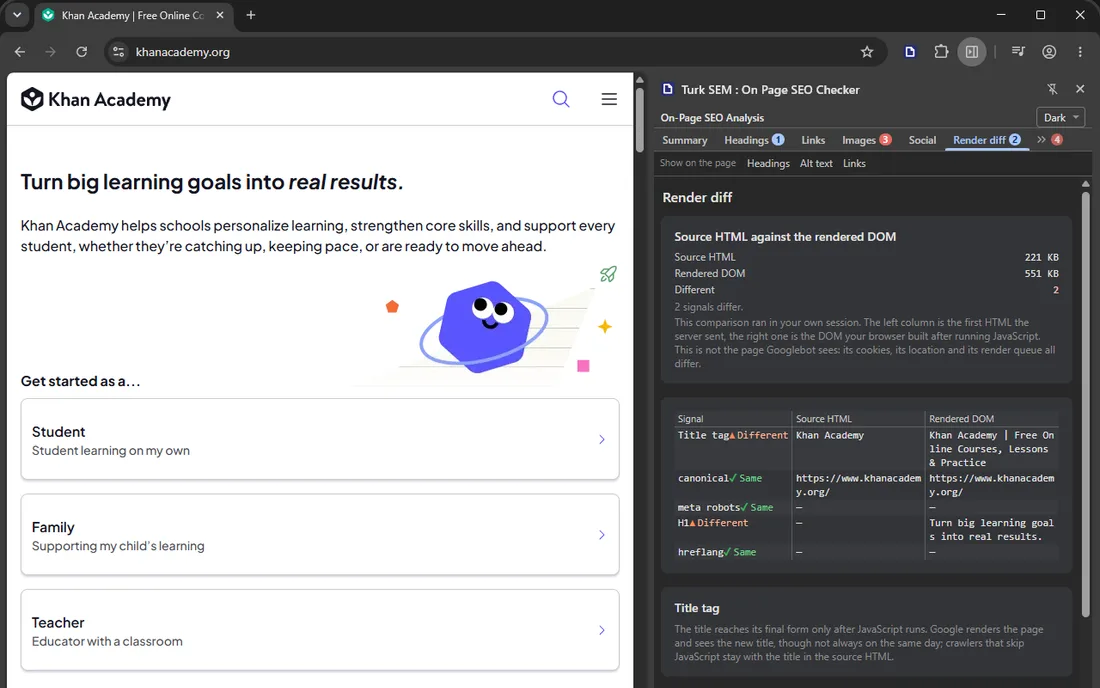
Bei modernen Stacks steckt in dieser Lücke die Mehrzahl der Überraschungen. Ein Titel, der im Browser richtig aussieht, kann im Quelltext etwas ganz anderes sein.
Befunde, direkt auf der Seite eingezeichnet
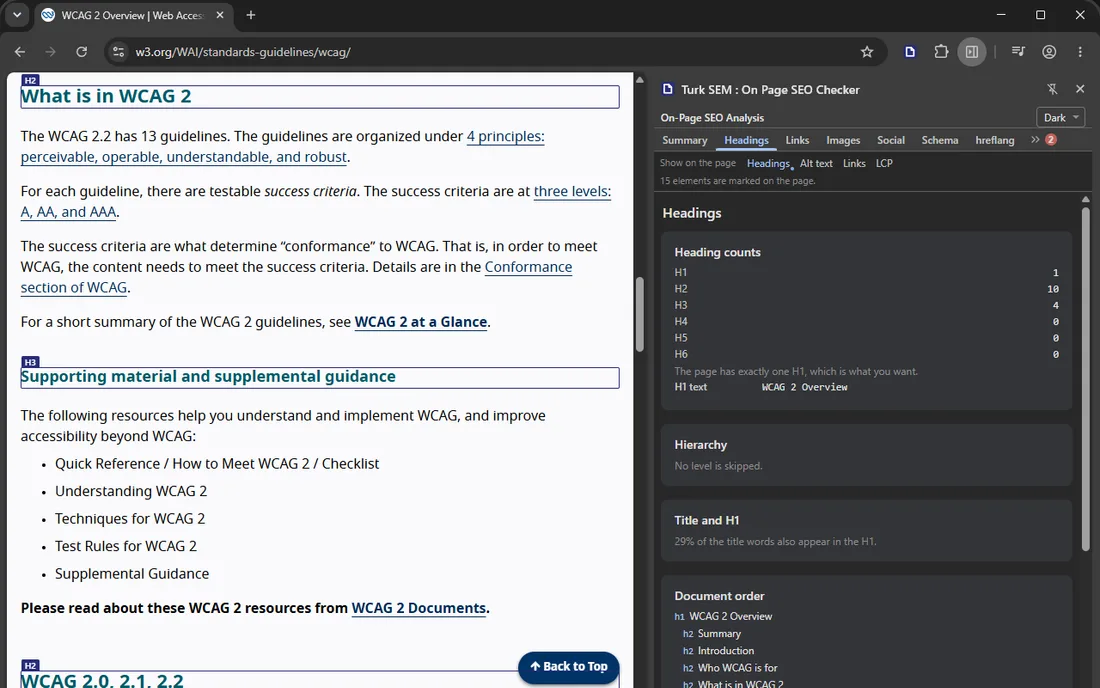
Statt einen Bericht zu lesen, sehen Sie sich die Seite an. Die Erweiterung kartiert die Überschriften, markiert Bilder ganz ohne Alt-Attribut (getrennt von einem bewusst gesetzten alt=""; das sind zwei verschiedene Dinge), weist auf nofollow- und sponsored-Links hin, greift unklare Linktexte wie „hier klicken“ heraus und zeigt auf das größte Inhaltselement.
Sichtbarkeit für KI-Crawler
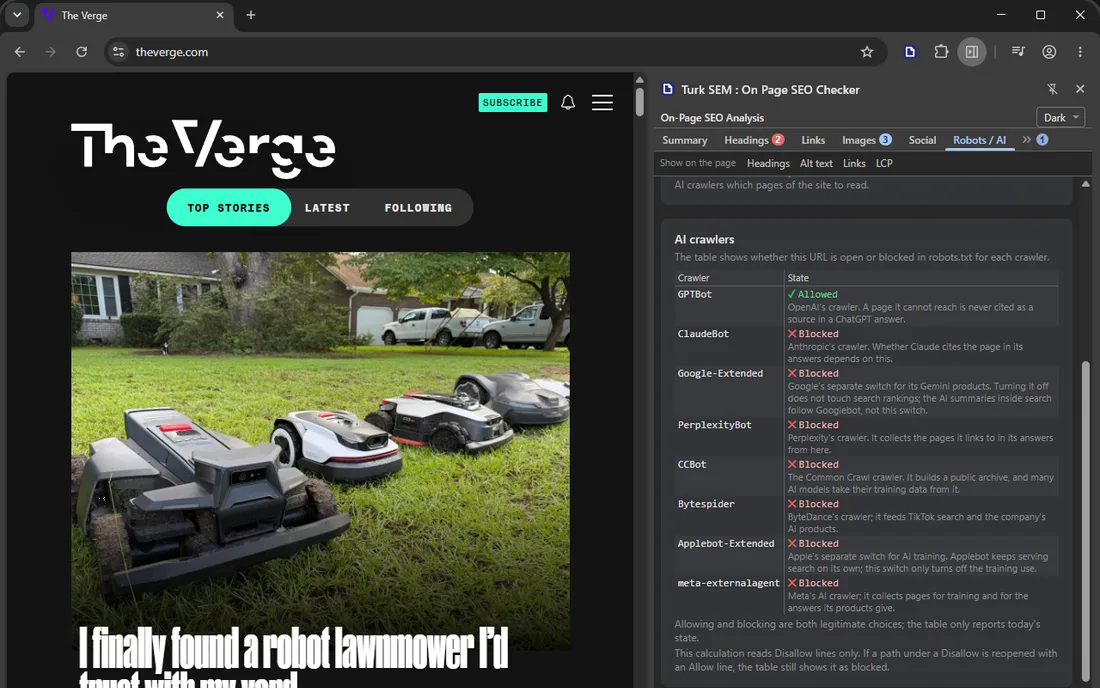
Ob die Website eine llms.txt hat, dazu eine Tabelle mit acht Bots, gelesen aus der robots.txt: GPTBot, ClaudeBot, Google-Extended, PerplexityBot, CCBot und die übrigen. Suche heißt längst nicht mehr nur Google. Menschen fragen auch Antwortmaschinen, und Sie sollten wissen, ob Ihre Website für sie offen ist.
Die Klassiker
Title und Description in Zeichen und in Pixeln. Pixel zählen, weil Google nach Pixelbreite kürzt und nicht nach Zeichenzahl. Daneben: eine Vorschau des Suchergebnisses, der Überschriftenbaum, interne und externe Links samt ihrer rel-Verteilung, die Abdeckung der Bild-Alt-Texte. Ebenso die Vorschauen für Open Graph und Twitter Card. JSON-LD-Blöcke werden mit dem jeweils möglichen Rich Result aufgeführt. Zuletzt hreflang-Tags, Wortzahl, Lesbarkeit und Keyword-Dichte.
Tempo, im Tab selbst gemessen
LCP, CLS, INP, FCP, TTFB, DOM-Meilensteine und Übertragungsgrößen. Keine Schätzung eines fernen Servers; eine Messung dort, wo die Seite tatsächlich geladen hat. Das Gegenstück im Tab zu den Metriken, die wir in unserem PageSpeed-Portal behandle.
Die Befunde an Ihren KI-Assistenten übergeben
Wenn Sie mit einem KI-Assistenten programmieren, zahlt sich dieser Teil aus. Eine Schaltfläche verwandelt die Befunde in ein Aufgabendokument, mit dem Ihr Assistent arbeiten kann: was gefunden wurde, in welcher Datei zu suchen ist, was ein klarer Fehler ist und was eine Beobachtung, die auf Ihre Entscheidung wartet.
Das Dokument ist immer auf Englisch. Das ist eine bewusste Entscheidung und keine fehlende Übersetzung, denn Coding-Assistenten befolgen englische Anweisungen zuverlässiger.
Was sie nicht tut
Einer Vorstellung, die ihre Grenzen verschweigt, traue ich selbst nicht. Also nennen wir unsere.
Dies ist ein Werkzeug für eine Seite, nicht für eine Website. Es sieht sich den offenen Tab an. Wenn Sie eine Website mit tausend Seiten von vorn bis hinten crawlen wollen, ist das eine andere Aufgabe.
Über Rankings sagt es nichts. Es kennt weder Ihre Position noch Ihre Mitbewerber oder das Suchvolumen; dafür braucht es externe Datenquellen, und diese Erweiterung verbindet sich mit keiner. Aus demselben Grund zeigt sie auch keine Backlinks.
Vier Anfragen gehen an den Server der Seite selbst: robots.txt, llms.txt, ein HEAD und ein GET. Sie gehen an Ihre Website, nicht an unsere.
Kurz gesagt
Onpage-SEO wird seit Jahren als Arbeit nach dem Start behandelt. Der Moment, in dem sie eigentlich stattfinden sollte, ist aber der, in dem die Seite für alle noch geschlossen ist. Diese Lücke sah für mich nach einer echten Lücke aus; also haben wir sie geschlossen.
Die Erweiterung ist im Chrome Web Store kostenlos erhältlich: On Page SEO Checker. Installieren Sie sie, öffnen Sie Ihren localhost:3000, starten Sie sie. Sehen Sie den Zustand Ihrer Seite vor allen anderen.