Erweiterung für Chrome & Edge · On-Page-SEO

Ein Klick, und die Seite vor Ihnen ist vollständig gelesen

Turk SEM : On Page SEO Checker öffnet ein Panel neben der Seite und lässt dort 53 Prüfungen laufen. Er zählt Ihnen nicht bloß Tags auf, sondern beantwortet die Frage, mit der Sie gekommen sind: Kann Google diese Seite indexieren, was ändert JavaScript nach dem Laden, und welche KI-Crawler kommen herein. Die gesamte Analyse läuft in Ihrem Browser, also ohne Konto, ohne Anmeldung und ohne dass irgendetwas hochgeladen wird.

Sie können den Store nicht nutzen? Laden Sie das Paket herunter und binden Sie es über den Entwicklermodus ein.

Version
0.1.0
Paketgröße
362 KB
Browser
Chrome / Edge 116+
Konto
Nicht nötig
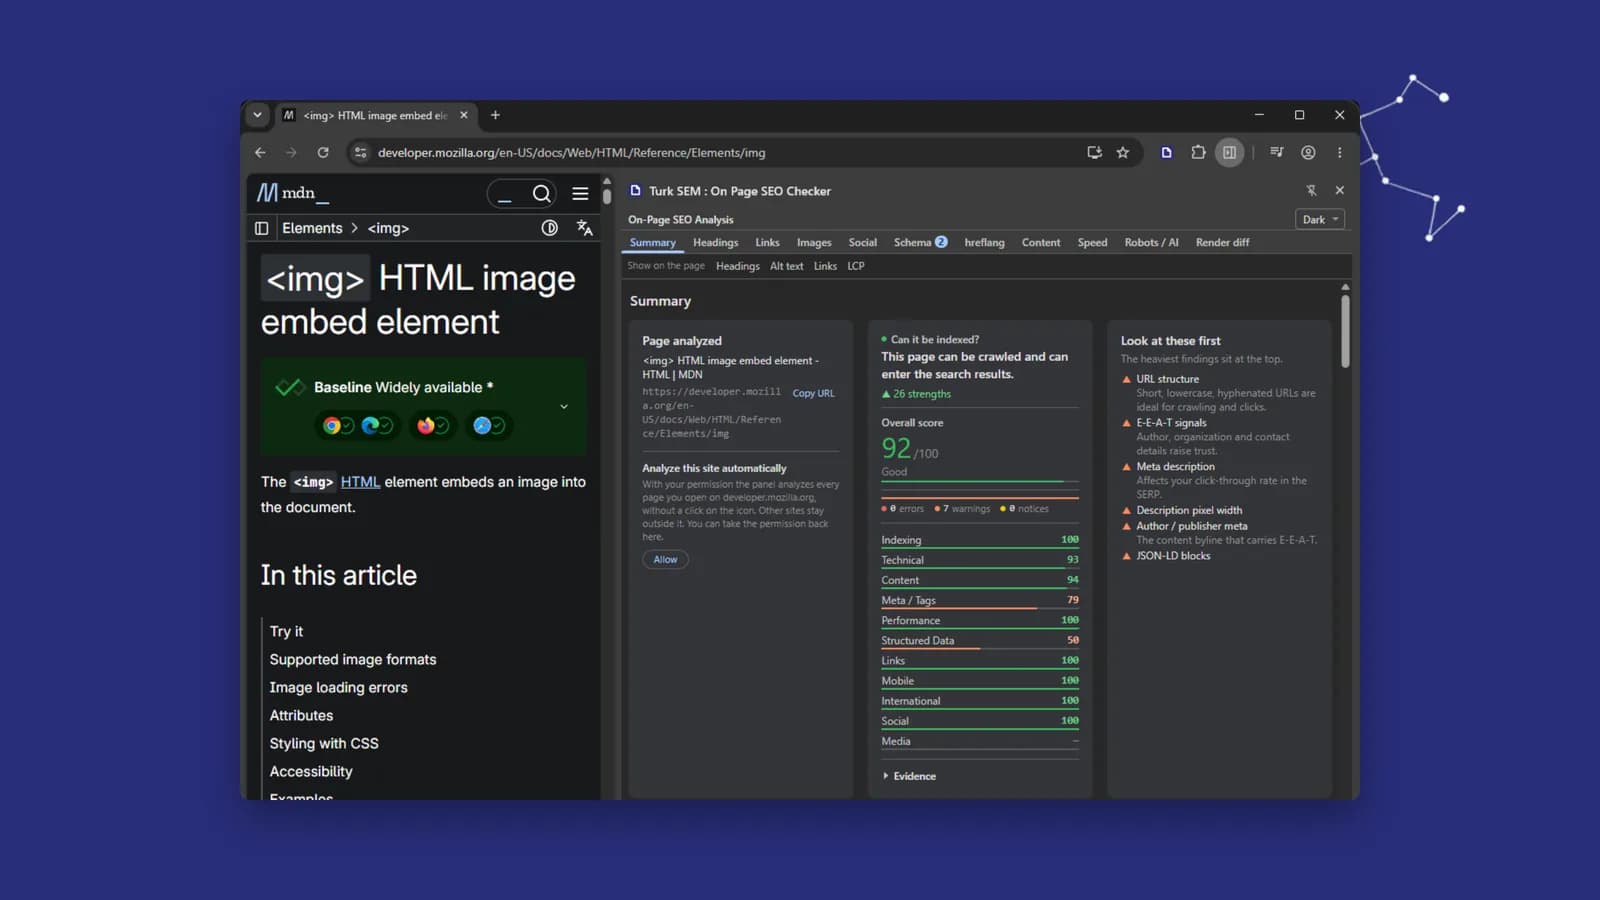
Das Seitenpanel von Turk SEM : On Page SEO Checker in Chrome, geöffnet neben einer MDN-Referenzseite: welche Seite analysiert wurde, ob sie indexiert werden kann, die Gesamtwertung und die Wertung jeder Kategorie.
Ein echter Durchgang, neben der MDN-Seite zum img-Element. Die Zahlen gehören zu dieser Seite, Ihre eigene Seite bringt eigene Zahlen.

Die Antwort statt der Tags

Ein Satz dazu, ob Google diese Seite indexieren kann

Über die Indexierbarkeit entscheiden fünf Signale, und sie heben einander auf. Die meisten Werkzeuge drucken alle fünf in eigene Zeilen und überlassen Ihnen das Lesen, dabei ist genau dieses Lesen die eigentliche Arbeit. Das Panel übernimmt sie: Es wiegt die Signale in der Reihenfolge, in der Google sie anwendet, und schreibt einen Satz. Widersprechen sich zwei davon, sagt der Satz es und nennt das Signal, das gewinnt.

Was nicht gelesen werden konnte, wird nie geraten. Blieb die robots.txt unlesbar, erklärt sich das Urteil selbst für unvollständig und nennt, was fehlt. Auch ein sauberes Urteil auf dünner Grundlage verliert sein Grün und wird neutral, denn eine gute Nachricht ohne Beleg ist keine gute Nachricht.

  1. 1

    robots.txt

    Ein Disallow kommt zuerst. Kann Google die Seite nicht laden, liest es auch das noindex darin nicht. Genau daher rührt der häufige Fall: das noindex steht drin, die Seite steht weiter im Index.

  2. 2

    X-Robots-Tag und meta robots

    Diese beiden stehen auf derselben Ebene. Widersprechen sie sich, wendet Google das strengere an; das Panel tut dasselbe und meldet den Widerspruch, statt Ihnen zwei Zeilen zum Vergleichen hinzulegen.

  3. 3

    meta-Tag für Googlebot

    Eine Regel für einen einzelnen Bot schlägt das allgemeine robots-Tag.

  4. 4

    canonical

    Ein Hinweis, keine Anweisung. Es nimmt die Seite nicht aus dem Index, es entscheidet, welche Adresse gelistet wird. Neben einem noindex entsteht der Widerspruch, vor dem Google ausdrücklich warnt.

  5. 5

    hreflang

    Kommt zuletzt und betrifft nur, welche Sprachfassung gezeigt wird. Ein Satz ohne Selbstverweis wird ganz ignoriert, und ein canonical auf eine andere Adresse hebt ihn ebenfalls auf.

Was das Panel schreibt

Die Seite trägt ein noindex, und ihr canonical zeigt auf eine andere Adresse. Google soll diese Seite fallen lassen und zugleich eine andere gutschreiben; die beiden Anweisungen arbeiten gegeneinander. Entscheiden Sie, welche Sie gemeint haben.

Elf Abschnitte, und jede Zahl kommt aus demselben Kern

Im Panel steckt der Kern, der auch die SEO-Analyse von turksem.com antreibt, in die Erweiterung hineinkompiliert: 53 Prüfungen mit denselben Schlüsseln und denselben Schwellen. Auf dem Bildschirm wird nichts neu gerechnet, deshalb können die Zahl im Panel und die Zahl auf der Website nicht auseinanderlaufen. Eine Prüfung ohne Messwert liefert nichts statt einer Null, und der Abschnitt zeichnet die Lücke ehrlich ein.

01

Überblick

Titel und vollständige Adresse der analysierten Seite, das Urteil, der Wert, der Balken nach Schwere und die Prüfungen, die zuerst dran sind.

02

Überschriften

Zähler von H1 bis H6, das Urteil zur H1, Sprünge in der Hierarchie wie h2 auf h4, und der Baum in der Reihenfolge des Dokuments.

03

Links

Interne, externe und eindeutige Links, die Aufteilung nach rel, die meistverlinkten Domains und die vagen Ankertexte.

04

Bilder

Alle Bilder werden gezählt, und ein fehlendes alt-Attribut bleibt von einem bewusst leeren getrennt.

05

Social Media

Die Open-Graph-Tabelle, der Kartentyp und Vorschauen, die ohne Download des Bildes gezeichnet werden.

06

Schema

Zahl der Blöcke und Typen, welche Rich Results damit noch erreichbar sind, und das rohe JSON-LD zum Aufklappen.

07

hreflang

html lang, og:locale, die Tabelle der Tags sowie die Urteile zu Selbstverweis und x-default.

08

Inhalt

Wortzahl, Verhältnis von Text zu HTML, Lesbarkeit, Dichte der Begriffe und die Datumsangaben auf der Seite.

09

Tempo

LCP, CLS, INP, FCP und TTFB, gemessen im Tab durch die Schnittstellen des Browsers selbst. Kein Messdienst wird aufgerufen.

10

Robots / KI

Der Googlebot auf genau diesem Pfad, die Sitemap-Zeilen, die Matrix der KI-Crawler und llms.txt.

11

Render-Unterschied

Was das erste HTML sagte, und was JavaScript daran geändert hat.

www.example.com/pricing
Turk SEM : On Page SEO Checker
ÜberblickÜberschriftenLinks2

Analysierte Seite

Preise und Pakete

https://www.example.com/pricing

Indexierbarkeit

Die robots.txt hält den Googlebot von dieser Adresse fern, deshalb liest er das noindex in der Seite nie. Öffnen Sie zuerst das Crawling, dann kann das noindex seine Arbeit tun.

68von 100
4 Fehler9 Warnungen32 bestanden

Meta

1

Inhalt

4

Links

0

Medien

3

Strukturiert

1

Technik

4

robots.txt und Quelltext werden beim Server angefragt

Ein Beispielbildschirm. Die Zahlen gehören zu einer Demoseite; Ihr eigener Durchgang bringt eigene Zahlen.

Was das erste HTML sagte, und was JavaScript daran geändert hat

Die Erweiterung holt den Quelltext ein zweites Mal und liest ihn mit demselben Parser, der schon das gerenderte DOM gelesen hat; danach vergleicht sie fünf Signale. Ein Titel, der erst nach einem Skript erscheint, ein canonical, das JavaScript nachträglich einsetzt, eine H1, die sich bei der Hydration ändert: Ein Werkzeug, das allein das DOM liest, zeigt Ihnen die fertige Seite und verrät nie, dass das erste HTML etwas anderes sagte.

Das ist Ihre eigene Sitzung, nicht die des Googlebot. Die Anfrage nach dem Quelltext ging mit Ihren Cookies und von Ihrem Standort aus los; der Googlebot hat beides nicht und arbeitet mit einer eigenen Warteschlange fürs Rendern. Wird die Anfrage umgeleitet, findet der Vergleich gar nicht statt, denn dann sind die beiden Seiten nicht mehr dasselbe Dokument.

QuelltextGerendertes DOM
  • titlePreise und PaketePreise und Pakete
  • canonicalfehlthttps://www.example.com/pricing
  • meta robotsnoindexnoindex
  • H1-Folge(keine)Preise und Pakete
  • hreflangen, de, x-defaulten, de, x-default

Auf dieser Seite gehen zwei der fünf Signale auseinander. Beide setzt ein Skript, das erste HTML für Google trägt also keines von beiden.

Welche KI-Crawler Ihre robots.txt hereinlässt

Acht KI-Crawler werden einzeln gegen Ihre robots.txt geprüft, und eine llms.txt wird gelesen, falls es sie gibt. Einen Crawler auszusperren ist eine Entscheidung und kein Fehler; das Panel behandelt es auch so: Nur eine Sperre für den Googlebot bekommt eine rote Markierung, und eine fehlende llms.txt wird ohne Markierung gemeldet, denn diese Datei ist noch nicht einmal ein Standard.

KI-Crawler auf dieser Adresse

  • GPTBotErlaubt
  • ClaudeBotErlaubt
  • Google-ExtendedGesperrt
  • PerplexityBotErlaubt
  • CCBotGesperrt
  • BytespiderGesperrt
  • Applebot-ExtendedErlaubt
  • meta-externalagentErlaubt
llms.txt1,4 KB, 6 Überschriften

Einen Crawler zu sperren ist Ihre Entscheidung. Nichts davon wird der Seite angelastet.

Der Befund, gezeichnet auf der Seite, die Sie ansehen

Eine Liste sagt Ihnen, dass neun Bildern der Alternativtext fehlt. Das Overlay zeigt Ihnen, welche neun. Vier Modi zeichnen direkt auf die Seite: jede Überschrift mit ihrer Ebene, Bilder ohne alt-Attribut in Rot und bewusst leere in Indigo, nofollow und vage Ankertexte an den Links, dazu das größte Element, das der Browser gemeldet hat. Die Seite bleibt dabei anklickbar, und es bleibt nichts zurück: Jede Markierung trägt ein einziges Attribut, und beim Ausschalten wird genau dieses Attribut abgefragt und alles entfernt, was zurückkommt.

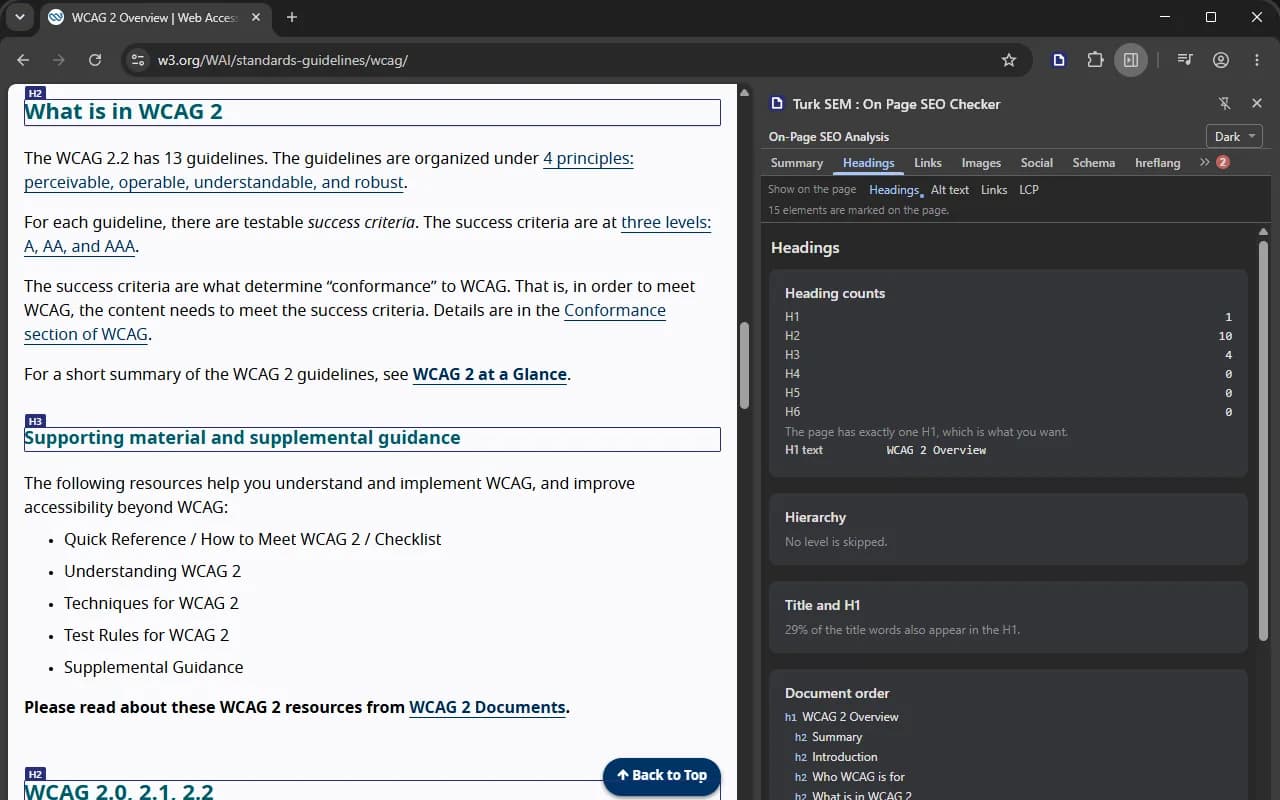
Eine Seite auf w3.org, über die die Erweiterung ihre Überschriften-Markierungen gezeichnet hat: Jede Überschrift ist umrandet und trägt ihre Ebene auf einem kleinen Chip, daneben zählt das Panel die Überschriften.
Der Modus Überschriften, auf der WCAG-Übersicht bei w3.org. Das Panel schreibt, wie viele Markierungen es gezeichnet hat, und die anderen drei Modi arbeiten genauso.

Der Teil, den sonst niemand bietet

Ein Briefing für den Assistenten, der die Korrektur schreibt

Sie lesen einen Befund und gehen dann korrigieren, meist in einem Editor mit einem Coding-Assistenten daneben. Ein Druck auf den Kopierknopf legt Ihnen das Panel ein Aufgabendokument in die Zwischenablage: die genaue Adresse, die Technik hinter der Seite, und jedes Problem mit dem Schlüssel seines Analysators, dem gemessenen Wert im Wortlaut, der verletzten Regel und der Stelle im Dokument. Fügen Sie es in Claude Code, Cursor oder Copilot ein, und der Assistent legt los, statt Sie zu fragen, um welche Seite es ging.

Befunde, über die auch eine korrekte Seite stolpern kann, bekommen keine Anweisung. Die Dichte eines Begriffs auf einer Seite, deren Thema genau dieses Wort ist, oder ein Verhältnis von Text zu HTML, das in jedem Komponenten-Framework normal ist: Sie landen in einem eigenen Abschnitt, mit dem gemessenen Wert und der Regel, aber ohne Aufgabe, und eine Zeile trägt dem Assistenten auf, vorher zu fragen und ein „so lassen“ als Antwort gelten zu lassen. Ein Mensch zuckt bei einem Fehlalarm mit den Schultern. Ein Agent committet ihn.

Das Dokument ist auch im türkischen und im deutschen Panel englisch, und das Panel erklärt Ihnen den Grund in Ihrer Sprache. Sein Leser schreibt Code, und die Begriffe, die es benennen muss, sind englisch: metadata, canonical, noindex, hreflang. Ein deutscher Bericht würde ein deutsches Wort neben ein englisches Attribut setzen und den Agenten einladen, eines zu erfinden.

Bericht für Ihren Coding-AssistentenFür die KI kopieren
# On-page SEO fix brief (for an AI coding assistant)
 
- URL: https://www.example.com/pricing
- Page title: Pricing and plans
- Stack: Next.js (framework)
- Checks: 53 analyzers ran on this page. 32 passed,
8 returned information rather than a verdict, 13 came
back with a problem.
 
## 1. CRITICAL ERRORS (2)
 
### 1.1 Meta robots (`meta.robots`)
Observed: noindex, follow
Rule: robots.txt blocks this path, so the noindex is
never read and the page can stay listed.
Where: head, and the Disallow line in robots.txt
Task: Open crawling for this path first, then leave
the noindex to do its job.
Acceptance criterion: Googlebot can fetch the URL and
the noindex is the only instruction left.
 
### 1.2 Canonical (`meta.canonical`)
Observed: https://www.example.com/plans
Render: this canonical is not in the initial HTML,
JavaScript injects it after load.

Der Bericht wird gezeigt, bevor er kopiert wird. Niemand sollte ein Dokument ungelesen in die eigene Codebasis einfügen.

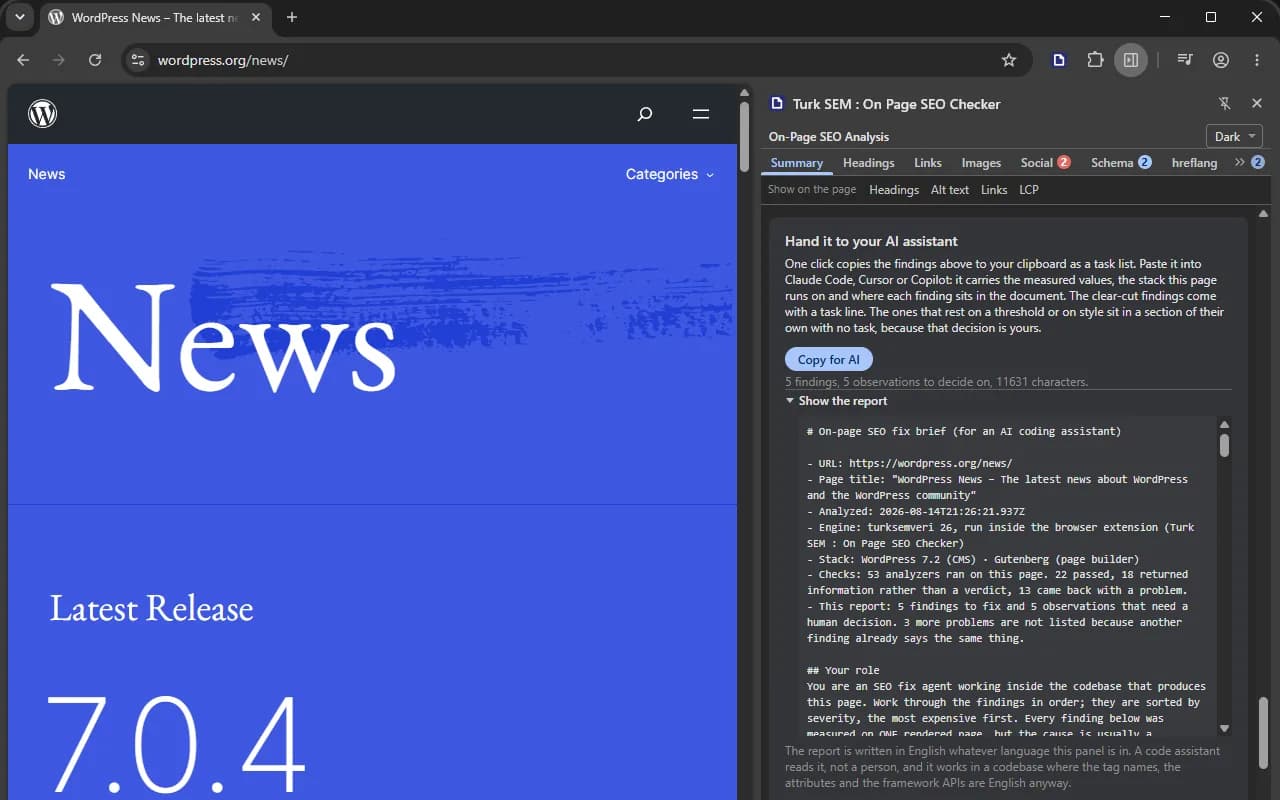
Die Berichtskarte im Panel auf einer echten Seite, das Dokument aufgeklappt: die Adresse, die Technik hinter der Seite, wie viele Prüfungen bestanden haben, und die Befunde.
Der Bericht so, wie das Panel ihn zeigt, auf einer echten Seite. Er wird vor dem Kopieren aufgeklappt, damit Sie das Dokument vor Ihrem Assistenten lesen.

Es folgt Ihnen, während Sie surfen

Klicken Sie einen Link an, wechseln Sie in einer Single-Page-App die Route oder laden Sie den Tab neu: Das Panel merkt es binnen weniger Sekunden und analysiert die neue Seite von selbst, ganz ohne zweiten Klick. Ein neutraler Streifen nennt die neue Adresse und sagt, dass die Ergebnisse darunter zu ihr gehören; danach verschwindet er wieder. Nur einem Wechsel auf eine andere Website kann es nicht folgen, weil Chrome dort die Berechtigung zurücknimmt, und das Panel sagt das offen, statt Ihnen die Zahlen der vorigen Seite unter einer neuen Adresse zu lassen.

Die Seite in diesem Tab hat gewechselt: www.example.com/plans. Die Ergebnisse darunter gehören zu dieser neuen Seite.
Der Tab ist auf eine Seite gewechselt, die diese Erweiterung nicht lesen darf. Klicken Sie erneut auf das Symbol.

Vier Berechtigungen, keine Host-Berechtigung, keine Datensammlung

Das Installationsfenster verlangt gar nichts, und die Detailseite unter chrome://extensions sagt, dass die Erweiterung keine besonderen Berechtigungen braucht und keinen zusätzlichen Zugriff auf Websites hat. Das ist keine geschickte Formulierung, sondern genau das, was im Manifest steht, und Sie können es im heruntergeladenen Paket nachlesen.

activeTab
Nur der eine Tab, auf dessen Symbol Sie geklickt haben, und erst ab diesem Klick. Sonst ist im Browser nichts erreichbar.
scripting
Den Leser in diesen Tab setzen und ihn zurücksetzen, wenn eine Navigation ihn herausreißt. Es gibt keine statischen Content-Skripte, also läuft auf keiner Seite von allein etwas.
storage
Der Zwischenspeicher für die robots.txt, im Arbeitsspeicher und beim Schließen des Browsers gelöscht. Auf die Festplatte kommt genau eines: das Design, das Sie gewählt haben.
sidePanel
Das Panel öffnen.
  • Jede Netzwerkanfrage geht an die geprüfte Website und sonst nirgendwohin, und sie verlässt einen Worker ohne Dokument; ein Preload-Header dieser Website kann das Panel also nicht dazu bringen, etwas bei Dritten zu laden.
  • Das Bild der Sharing-Karte wird nie geladen. Seine Adresse steht als Text im Vorschaurahmen.
  • Der Block ganz oben im Überblick nennt immer die genaue Adresse, zu der die Zahlen gehören.
  • Kein Konto, keine Anmeldung, kein Tracking und keine einzige Anfrage an einen Server von Türk SEM.

Was es Ihnen nicht sagen kann

Eine Grenze gilt erst als erklärt, wenn sie aufgeschrieben ist; deshalb steht das hier auf der Seite und nicht in einer Fußnote.

Die Tempowerte stammen aus einer Sitzung auf einem Gerät.

LCP, CLS und INP kommen aus den Schnittstellen des Browsers, während Sie auf der Seite sind. Felddaten misst man über ganze Besuche echter Nutzer hinweg, und das ist hier nicht der Fall. Der Wert für die Layoutverschiebung summiert außerdem die ganze Sitzung, statt nur das Fünf-Sekunden-Fenster mit der stärksten Verschiebung zu nehmen. Er liegt damit gleichauf mit der veröffentlichten Kennzahl oder darüber, und das Panel schreibt das auf den Bildschirm.

Es liest eine Seite, nicht eine ganze Website.

Verwaiste Seiten, Weiterleitungsketten, Klicktiefe und Titel, die sich über eine Vorlage hinweg wiederholen, sind Fragen an die ganze Website; eine einzelne Seite kann sie nicht beantworten. Dafür gibt es unsere Erweiterung Website-Crawler: Sie läuft jede Seite ab und legt jeden Durchgang versioniert in Ihrem Panel ab.

Es folgt den gefundenen Links nicht.

Keine Adresse, die auf der Seite steht, wird abgerufen. Deshalb steht hier nicht, ob ein Link aufgeht, ob das Bild der Sharing-Karte existiert oder ob das Ziel des canonical lebt. Auch hreflang wird nur auf dieser Seite gelesen, die Gegenseitigkeit bleibt also ungemessen.

Der HTTP-Statuscode der Seite wird nicht gemessen.

Eine HEAD-Anfrage kennt den Status ihrer eigenen Anfrage, nicht den der Antwort, die Ihr Tab geladen hat, und viele Server antworten auf HEAD mit 405. Diese Zahl als Status der Seite hinzuschreiben hieße, etwas zu melden, das niemand gemessen hat; sie bleibt deshalb unbekannt.

Stattdessen eine ganze Website crawlen

Einrichten

Sobald die Erweiterung im Store steht, genügt ein Klick. Bis dahin laden Sie das Paket herunter und binden es über den Entwicklermodus ein. Beide Wege geht man nur einmal, und der Browser muss dafür nicht neu starten.

Im Chrome Web Store installieren (empfohlen)

Ein Klick genügt, und Aktualisierungen kommen von selbst. Beim ersten Klick auf das Symbol in der Leiste geht das Panel auf.

Im Chrome Web Store installieren

Wenn der Store nicht geht: von Hand einrichten

  1. 1Das Paket herunterladen (.zip)
  2. 2Mit der rechten Maustaste auf die ZIP-Datei klicken und sie in einen Ordner entpacken
  3. 3chrome://extensions öffnen
  4. 4Rechts oben den Entwicklermodus einschalten
  5. 5Entpackte Erweiterung laden wählen
  6. 6Den entpackten ORDNER auswählen

Das sorgt oft für Verwirrung: Chromes Fenster zur Ordnerauswahl zeigt nur Ordner, die heruntergeladene .zip Datei erscheint dort also nicht. Das ist kein Fehler; der Ordner, der nach dem Entpacken entsteht, wird angezeigt, und genau den wählen Sie aus.

Zur Dokumentation

Häufig gestellte Fragen

Kostet die Erweiterung etwas?

Nein. Sie ist kostenlos und läuft ohne ein Konto bei Türk SEM. Nichts darin steckt hinter einer Anmeldung.

Verlassen meine Seitendaten den Browser?

Nein. Die Analyse läuft im Panel, auf dem HTML, das Ihr Browser ohnehin schon geladen hat. Die einzigen Anfragen der Erweiterung gehen an die geprüfte Website: ihre robots.txt, ihre llms.txt, eine HEAD-Anfrage und ein Abruf des Quelltexts für den Vergleich. Nicht eine Anfrage erreicht einen Server von Türk SEM, und hochgeladen wird nirgendwohin etwas.

Warum verlangt sie so wenige Berechtigungen?

Weil sie immer nur den Tab liest, auf dessen Symbol Sie geklickt haben. Es gibt keine Host-Berechtigung, keinen Zugriff auf alle Websites und kein statisches Content-Skript, deshalb hat Chromes Installationsfenster nichts zu warnen. Wenn das Panel eine Website beim Surfen von selbst weiter prüfen soll, geben Sie genau diese eine Website im Panel frei und nehmen sie an derselben Stelle wieder zurück.

Kann sie Seiten hinter einer Anmeldung prüfen?

Ja. Sie liest die Seite, die Ihr Browser schon gerendert hat, in Ihrer eigenen Sitzung. Ein Mitgliederbereich, eine Testumgebung oder eine Seite hinter dem Login wird also genau so gelesen, wie Sie sie sehen.

Worin unterscheidet sie sich von der SEO-Analyse auf turksem.com?

Es ist derselbe Kern an einem anderen Ort. Die Fassung auf der Website holt die Adresse von unserem Server und sieht deshalb den Status der Antwort und die Weiterleitungskette. Die Erweiterung liest die gerenderte Seite in Ihrem Browser, misst das Tempo im Tab und kann Befunde auf die Seite zeichnen. Nehmen Sie die Website für eine Adresse, die Sie nicht öffnen können, und die Erweiterung für die Seite vor Ihnen.

Crawlt sie meine ganze Website?

Nein, sie liest die eine Seite, auf der Sie stehen. Für die ganze Website läuft unsere Erweiterung Website-Crawler von der Startseite aus jede Seite ab und legt jeden Durchgang in Ihrem Panel ab.

Welche Browser werden unterstützt?

Chrome und Edge ab Version 116 sowie andere Browser auf Chromium-Basis mit der Schnittstelle für das Seitenpanel. Genau diese Schnittstelle braucht das Panel, und sie kam mit Version 116.

Was steht in dem Bericht, den ich in meinen Coding-Assistenten einfüge?

Die analysierte Adresse, der Titel der Seite, ein Zeitstempel, die Technik hinter der Seite und ausschließlich die Probleme: jedes mit dem Schlüssel seines Analysators, dem Wert so, wie er gemessen wurde, der verletzten Regel und der Stelle im Dokument. Bestandene Prüfungen zählt eine einzige Zeile, statt sie aufzulisten, und alles, was nicht gemessen werden konnte, wird benannt. So korrigiert der Assistent nichts, was niemand gelesen hat.

Lesen Sie jetzt die Seite, auf der Sie stehen

Kostenlos · Chrome & Edge 116+ · Ohne Konto · Nichts verlässt Ihren Browser

Erweiterung herunterladen (.zip)