
Die elf Abschnitte
Eine Leiste, elf Abschnitte, 53 Prüfungen. Jede Zahl auf dem Bildschirm stammt aus einer einzigen Auswertung und wird nicht je Abschnitt neu gerechnet. Panel und Bericht auf turksem.com können deshalb nicht auseinanderlaufen. Eine Prüfung ohne Messwert zeichnet eine ehrliche Lücke, niemals eine Null.
Überblick
Der erste Abschnitt, auf der vorigen Seite von vorn bis hinten beschrieben. Oben sitzen die Identitätskarte, das Urteil zur Indexierbarkeit, die Wertung mit ihren Bändern und das Raster der Kategorien. Darunter folgen die zuerst zu lesenden Befunde, die Maße der Seitenidentität in Zeichen und in Pixeln und die Vorschau des Suchergebnisses. Ganz unten stehen die E-E-A-T-Karte, das Akkordeon mit allen 53 Prüfungen und die Karte für den KI-Bericht.
Überschriften
Zähler von H1 bis H6, das Urteil zur H1 und übersprungene Ebenen, etwa eine h2 direkt gefolgt von einer h4. Danach kommt der Anteil des Titeltexts, der auch in der H1 auftaucht, und die Gliederung in Dokumentreihenfolge mit Einzug. Auf einer Seite mit mehr als 40 Überschriften bricht die Liste ab und nennt, wie viele sie zeigt.
Links
Zähler für interne, externe und einmalige Links, die Aufteilung der rel-Angaben (dofollow, nofollow, sponsored, ugc, ohne rel-Attribut, fehlendes noopener), die am häufigsten verlinkten Domains und die Zahl der Links, deren Text nichts aussagt. Die Links selbst stehen in zwei aufklappbaren Listen; ab 50 internen Links bricht die Liste ab und sagt es.
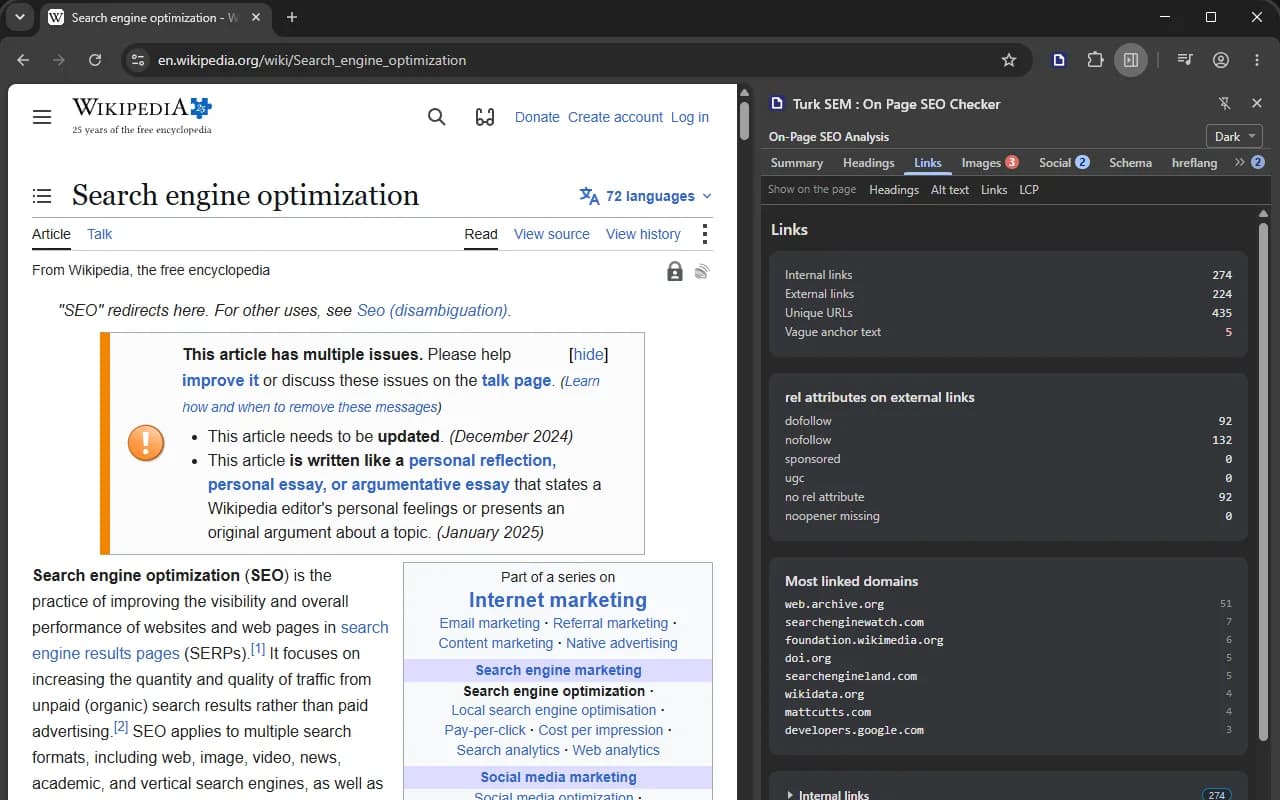
Was dieser Abschnitt nicht sagen kann: ob diese Links auch öffnen. Keine Adresse von der Seite wird abgerufen. Ein Link auf eine Seite, die 404 antwortet, zählt daher genauso wie einer, der funktioniert.
Bilder
Die Zähler erfassen jedes Bild der Seite. Die Liste darunter zeigt höchstens 12 Beispiele, und der Hinweis sagt das, denn der Analysator hält Beispiele statt eines vollständigen Verzeichnisses. Ein Bild ohne alt-Attribut wird hervorgehoben, und daneben steht die Zahl der Bilder, die sich besser ausliefern ließen.
Social Media
Die Open-Graph-Tabelle, der für X angemeldete Kartentyp und zwei Vorschauen. Das Vorschaubild wird nicht geladen: Seine Adresse steht als Text im Rahmen. Ein Bild von einem fremden Server zu holen, würde das Versprechen brechen, dass außer den vier Anfragen an die geprüfte Website nichts Ihren Browser verlässt. Ein relativer og:image-Pfad bekommt eine eigene Warnzeile.
Eine Grenze steht auf dem Bildschirm. Der Analysator führt og:title, og:image und og:type sowie die Liste fehlender Tags, aber nicht den Text von og:description, og:url und og:site_name. Die Beschreibungszeile der Vorschau füllt sich deshalb nur, wenn og:description ganz fehlt. Genau dann greifen die Plattformen ja tatsächlich auf die Meta-Beschreibung zurück.
Schema
Zahl der Blöcke und Typen, die Gruppen möglicher Rich Results, der Entitätengraph, die Werte, die wirklich im Suchergebnis ankommen, und unten die rohen JSON-LD-Blöcke. Diese Blöcke stammen aus dem erfassten HTML und nicht aus der Auswertung. Sie klappen also das Markup der Seite selbst auf. Lange Blöcke werden gekürzt, und die Kürzung steht dabei. Ein Block, der sich nicht lesen lässt, wird gezählt und hervorgehoben.
hreflang
Das lang-Attribut im html-Element, og:locale, Content-Language, die Tabelle der Tags sowie die Urteile zum Selbstverweis und zu x-default. Auf einer einsprachigen Website meldet der Abschnitt, dass es keine hreflang-Tags gibt, und hält fest, dass dies normal und kein Fehler ist.
Die Gegenrichtung bleibt außer Reichweite. Gelesen wurden nur die Codes dieser Seite und ihr Selbstverweis. Ob jede Alternative antwortet und zurückverweist, zeigen erst die anderen Seiten, und diese Erweiterung liest eine Seite.
Inhalt
Wortzahl, das Verhältnis von Text zu HTML am gerenderten DOM gemessen, Lesbarkeitswerte mit dem Hinweis, dass die Formeln auf Englisch geeicht sind, die Tabelle der Wortdichte und die Datumsangaben auf der Seite. Die Dichte kommt ohne Handlungsanweisung, denn auf einer Seite über ein Thema ist das häufigste Wort eben dieses Thema.
Tempo
Gemessen wird in Ihrem eigenen Tab, mit den Schnittstellen des Browsers. Kein Messdienst wird gerufen, und dafür geht keine Anfrage hinaus. Jeder Wert bekommt eine eigene Karte, die Zahl groß in der Farbe ihres Bandes, darunter das Wort des Bandes.
| Wert | Woher er kommt | Was er nicht sagen kann |
|---|---|---|
| LCP | Die Einträge largest-contentful-paint des Browsers, der letzte davon. | Es ist der Aufbau dieser Sitzung auf diesem Gerät, nicht das Erlebnis Ihrer Besucher. |
| CLS | Die Einträge zu Layoutverschiebungen, ohne die nach einer Eingabe, aufsummiert. | Vereinfacht. Der veröffentlichte Wert nimmt das dichteste Fenster von fünf Sekunden; dieser summiert die ganze Sitzung und liegt deshalb gleich hoch oder höher. Dieser Satz steht auf der Karte, nicht in einer Fußnote. |
| INP | Ereignisse über 40 ms, nach Interaktion gruppiert, hohes Perzentil. | Solange Sie nichts anklicken, gibt es nichts zu messen. Die Zeile sagt das, statt eine Null zu zeigen. |
| FCP und TTFB | Der Eintrag zum ersten Aufbau und der Eintrag zur Navigation. | Sie gehören zu diesem Ladevorgang. Nach einem Neuladen sind sie andere. |
| Größen, Meilensteine, Protokoll | Der Eintrag zur Navigation. | Den Antwortstatus liest das Panel dort, wo der Browser ihn meldet, und lässt die Zeile sonst leer, statt eine 200 zu behaupten. |
Die Farben der Bänder sind die veröffentlichten Schwellen der Core Web Vitals und keine eigene Skala: 2500 und 4000 ms für LCP, 0,1 und 0,25 für CLS, 200 und 500 ms für INP, 1800 und 3000 ms für FCP, 800 und 1800 ms für TTFB. Die Zahl auf dem Reiter zählt nur Werte im schlechten Band, denn das mittlere Band heißt verbesserungswürdig, und eine rote Zahl würde es als kaputt melden. Das Messfenster steht auf dem Bildschirm, und nach zwei Minuten sagt ein Satz, dass die Zahlen zu einem alten Ladevorgang gehören.
Robots / KI
Dieser Abschnitt und der nächste warten auf den Server der geprüften Website. Vier Anfragen gehen hinaus, alle an diese Website und sonst nirgendwohin: /robots.txt, /llms.txt, ein HEAD auf die Seitenadresse und ein GET auf die Seitenadresse.
Aus robots.txt liest der Abschnitt vier Dinge: ob Googlebot auf genau diesem Pfad offen ist, wie viele Disallow-Zeilen die Datei trägt, ob es ein Crawl-delay gibt und welche Sitemap-Zeilen dort stehen. Dazu kommt der Stand von acht KI-Crawlern, einzeln geprüft: GPTBot, ClaudeBot, Google-Extended, PerplexityBot, CCBot, Bytespider, Applebot-Extended und meta-externalagent. Jeden davon zu sperren ist eine legitime Entscheidung. Die Tabelle meldet den Stand und mischt sich nicht ein. Eine rote Zahl auf der Leiste löst nur eine Sperre für Googlebot aus.
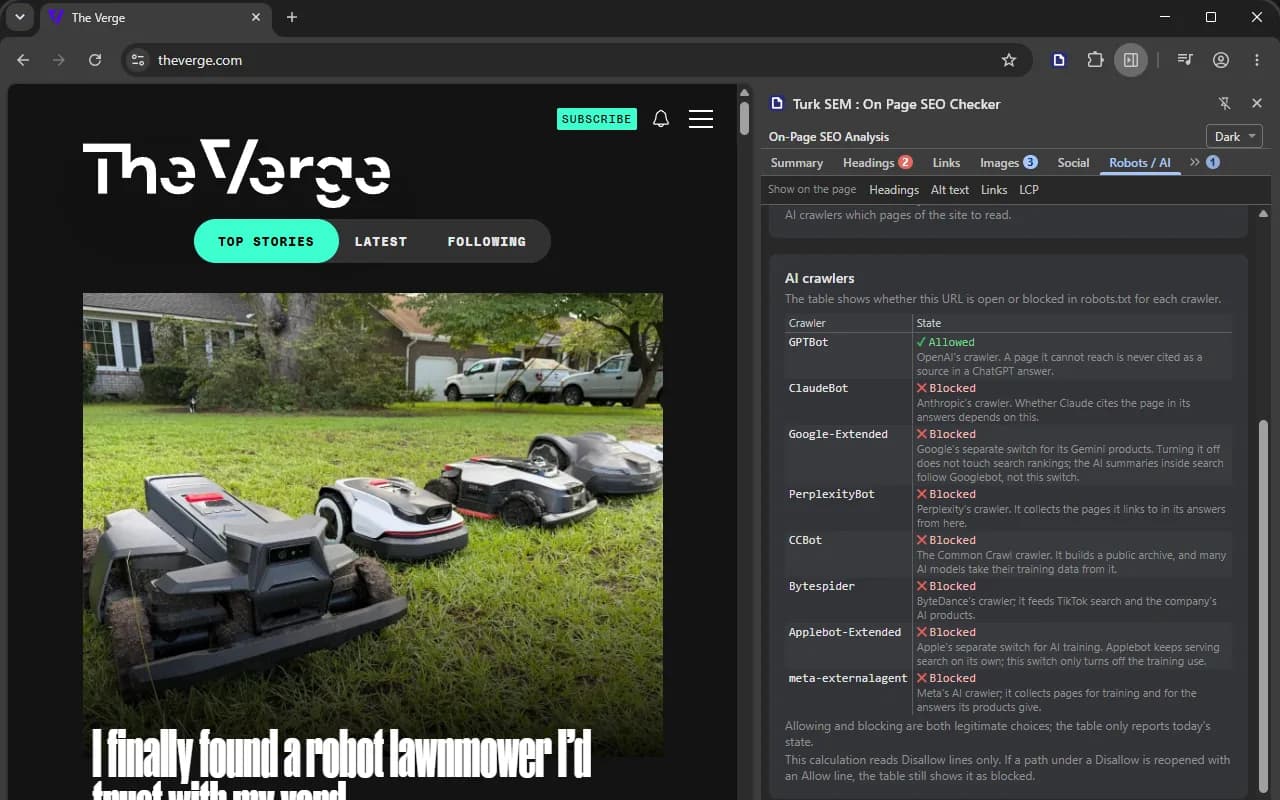
llms.txt bekommt eine eigene Karte: ob die Datei existiert, wie groß sie ist und welche Überschriften sie angibt. Eine fehlende llms.txt ist kein Fehler und löst keine rote Zahl aus, denn diese Datei ist nicht einmal ein Standard.
Eine bewusste Grenze
Der Leser der robots.txt beachtet Disallow-Zeilen und übergeht Allow-Zeilen. Er gehorcht also zu viel, und das ist für einen eigenen Crawler die sichere Richtung. Ein Pfad, den ein Disallow schließt und ein Allow wieder öffnet, erscheint deshalb als gesperrt. Der Abschnitt sagt das an zwei Stellen, statt Sie es später herausfinden zu lassen.
Render-Unterschied
Das HTML des Servers gegen das DOM, das Ihr Browser nach dem Ausführen von JavaScript aufgebaut hat, verglichen an fünf Signalen: Titel, canonical, meta robots, die Folge der H1 und der hreflang-Satz. Beide Seiten laufen durch denselben Parser und dieselbe Ableitung. Sie sehen also zwei Lesungen einer Maschine, nicht den Streit zweier verschiedener.
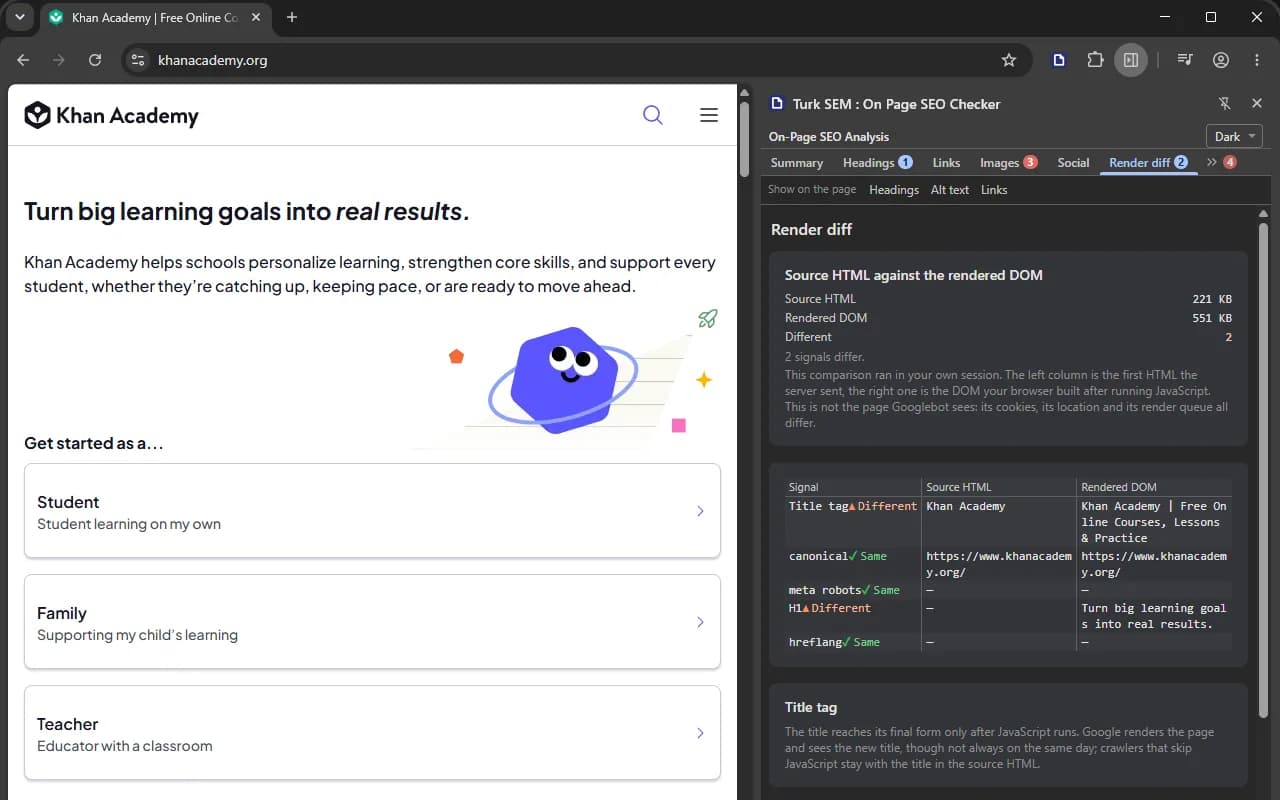
Die Warnung unter der Karte bleibt in allen drei Sprachen stehen, und sie ist der wichtige Teil: Das ist nicht das, was Googlebot sieht. Die Anfrage nach dem Quelltext ging in Ihrer Sitzung hinaus, mit Ihren Cookies, von Ihrem Standort. Googlebot hat keine Cookies, kommt aus einem anderen Land und hat eine eigene Warteschlange fürs Rendern.
Wurde die Anfrage nach dem Quelltext auf eine andere Adresse umgeleitet, findet gar kein Vergleich statt. Die beiden Seiten wären nicht dasselbe Dokument, und die Meldung, es gebe keinen Unterschied, wäre falsch.
Woher die Zahlen kommen
Das Panel trägt dieselbe Maschine, die den SEO-Bericht auf turksem.com rechnet, in die Erweiterung kompiliert: 53 Prüfungen mit denselben Schlüsseln und denselben Schwellen. Auf dem Bildschirm wird nichts neu gerechnet. Jede Zahl stammt aus einer Auswertung, und ein Wert, der nicht lesbar war, kommt leer zurück, damit der Abschnitt eine Lücke zeichnen kann.
Diese Auswertung läuft je Seite zweimal und nicht öfter. Der erste Durchgang füllt acht Abschnitte sofort. Sobald alle vier Abfragen zurück sind, erweitern die Antwortkopfzeilen und der Inhalt der robots.txt die Eingabe, und die Auswertung wird einmal aufgefrischt. Nach jeder einzelnen Abfrage aufzufrischen, hieße eine große Seite ohne Gewinn viermal zu lesen.